
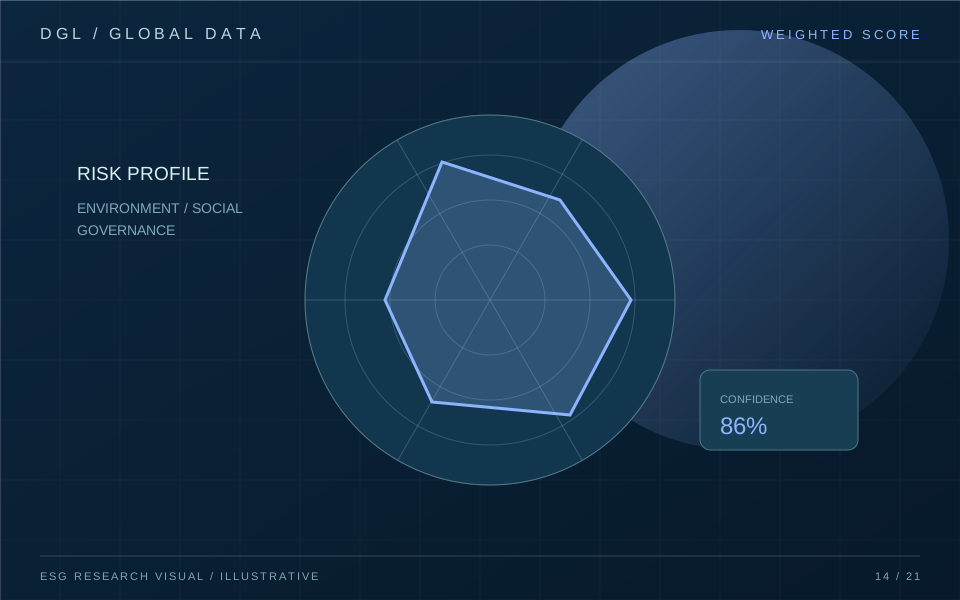
自动评分很容易做出一个数字,难的是说明这个数字衡量什么、遗漏什么,以及为什么会变化。AI 能改善数据处理效率,但一个不可解释的总分不应成为企业或投资者的唯一判断依据。
先声明评分目标
评价财务性风险、企业对环境社会的影响、披露成熟度,是三类不同问题。选择指标前必须说明目标人群和使用场景。若用于同行比较,行业分类与规模调整不可缺;若用于供应商尽调,重点可能是高严重度事件与证据有效性。模型还应注明数据截止日期,避免把最新处罚与上一年度披露当作同一时间切面。
E、S、G 不能只靠平均
排放强度对高耗能产业重要,劳动条件对服装供应链重要,董事会独立性对治理结构复杂的集团重要。权重应有行业逻辑并公开,无法观测的指标不能自动补成中性值。可同时展示环境、社会、治理三个子分及覆盖率,让使用者看到某家公司高总分是否只是因为易取得的环境指标较多。
AI 能处理文本,不能消除价值判断
模型可以识别政策、事件和报告中的量化数据,也能辅助合并同义指标。但“处罚是否改变长期风险”“政策承诺值多少分”仍需要方法论选择。模型训练样本若集中于英文大型上市公司,非英语地区和中小企业可能被系统性误判。人工标注抽检、地区分层误差和版本对比,应成为评分发布流程的一部分。
解释比单一分数更有用
评分页面最好拆解贡献最大的指标、数据来源、权重和敏感性。若某项缺失信息被估算,应显示估算区间;若重大事件导致降分,应链接到事件证据。使用者还可以观察调整权重后的排名变化。透明的评分不是声称无偏,而是让偏好、假设与不确定性能够被讨论和复核。
研究实践:把方法落实到记录
模型治理还包括申诉和复算。企业发现评分引用了旧报告时,应能够提交更正证据;研究团队复核后重跑受影响指标,并保留旧分数的历史记录。若模型版本调整导致整批企业分数变化,需要单独发布方法说明。公开这些变化,比假装分数恒定更有助于使用者判断趋势。
进一步观察
以制造业为例,可把排放强度、工伤率、董事会监督等指标分别标准化,再在行业内部比较。若一家企业未披露工伤率,系统可以给出覆盖率下降,而不是用零工伤代替。模型如使用估算值,则同时展示估算区间和对总分的影响。使用者若对某项权重有不同判断,可以看到调整后排名是否显著变化。
对评分的外部检验不应只看与另一家评级机构的相关性。更有价值的是错误案例复盘:哪些企业因为主体匹配错误被低估,哪些指标因为披露政策变化产生断点,哪些地区因语言覆盖不足系统性缺失。模型管理团队应公布这些限制,并在版本更新时说明修正范围。分数只有能被追问,才可能被负责任地使用。
研究建议
一个负责任的评分产品应允许用户下载方法说明和指标级数据。即使模型细节不能全部公开,至少应公布输入来源、主要权重、缺失值规则与更新频率。对影响较大的事件调整,还要能找到对应的公开证据和复核状态。
对行业边界模糊的企业,可以同时展示两个行业基准下的结果,并说明业务结构为何难以归类。强行分配唯一行业标签会让权重差异伪装成企业表现差异。对业务快速转型的企业,还要按财年更新行业标签,保留旧版评分的基准,避免时间序列中出现无法解释的断点。
本文为基于公开资料的方法研究,不构成投资、法律或具体企业评级意见。引用标准与监管动态请以原发布机构的最新文本为准。