
让大模型回答“这家公司过去三年的 Scope 2 排放如何变化”,并不是把报告塞进上下文就够了。报告版本、表格单位和检索范围任何一处出错,都可能让答案流畅却不真实。
从文档结构建立索引
全球 ESG 报告具有不同语言、版式和指标名称。解析时应把段落、表格、脚注与图像分开处理,把企业主键、财年、披露标准和报告版本作为元数据。向量索引擅长找语义相近段落,但具体数值查询还要结合关键词和结构化字段,避免检索到另一家公司的相似表格。
RAG 回答要可核验
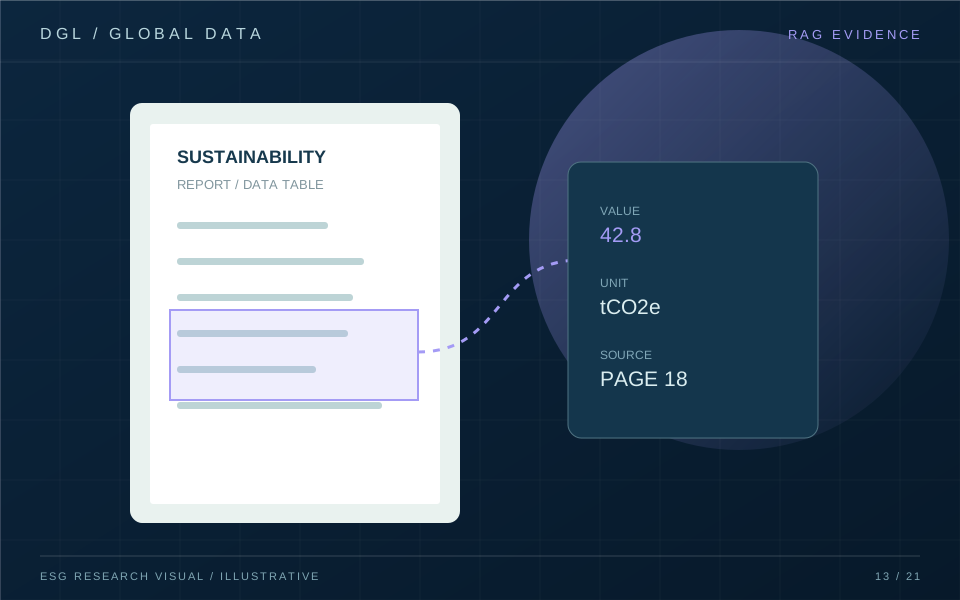
系统先检索候选证据,再生成回答;每一个关键数值都应附报告名称、页码和原文链接。引用片段与回答中的数字必须一致,不能只附一条看似相关的来源。跨年比较时,还要核对是否出现重述,以及市场法和位置法是否被混用。没有足够证据时,明确回答“未找到可靠披露”比编出精确数值更有用。
评估要覆盖困难样本
2026 年的 ESG 领域 RAG 研究使用真实报告评估模型,提示我们不宜只用少量演示问题判断系统质量。测试集应包括扫描表格、多语言脚注、同名企业、缺失数据和互相矛盾的版本。分别统计检索召回率、引用准确率、数值误差与拒答正确率,才能看出问题出在解析、检索还是生成。
人机协作是可信度的一部分
对于排名、合规或重大风险结论,可让模型给出候选答案与证据包,审核员确认后再发布。反馈应回流到字段字典与检索规则,而不是直接篡改原文。大模型扩大了阅读规模,可信度仍来自来源追踪、边界判断和持续评估。
研究实践:把方法落实到记录
可为每个问题记录‘正确来源集合’与可接受答案范围。例如问某年排放量,若报告同时给出重述前和重述后数值,测试集要指明使用哪个版本;问不存在的数据,正确答案应是拒答并说明检索范围。这样才能测出模型是否真的理解证据,而不只是拼接看似合理的段落。
进一步观察
研究系统可以把问题分成三类:直接查值、跨年比较和解释原因。直接查值主要检验解析与定位;跨年比较检验单位、边界和版本;解释原因则需要将报告叙述与结构化指标结合。若同一模型在第一类表现好,却在第三类编造因果,产品界面应限制自动结论的范围,而不是用平均准确率掩盖风险。
引用质量需要单独评估。模型给出的文档链接可能正确,但页码对应的是另一项指标;也可能引用旧版报告,数字看似合理。可以要求系统输出“原句或表格单元格—标准化字段—最终回答”的链条。审核员随机抽查链条的每一层,才能知道错误来自 OCR、检索、映射还是语言生成。
实践中的判断边界
产品界面可以设置证据等级:原表格直接支持、由多个片段推导、模型推测,以及未找到。用户问到监管或投资敏感问题时,只允许前两类形成结论,并要求人工复核。系统应允许点击每条证据返回报告原页,这种交互比在答案末尾堆一串笼统链接更有用。
研究建议
在展示层,可以要求每个回答附‘可核验程度’而非模型自信分数。可核验程度来自引用是否直达原页、数值是否通过规则校验、是否经过人工复核。模型给出高概率并不意味着这些证据齐全;两者应严格分开。
当模型或向量索引更新时,旧答案也需要回归测试。尤其是曾经发生错误的企业与指标,应保留固定问题集,验证升级没有再次引入跨主体或跨年度混淆。
本文为基于公开资料的方法研究,不构成投资、法律或具体企业评级意见。引用标准与监管动态请以原发布机构的最新文本为准。