
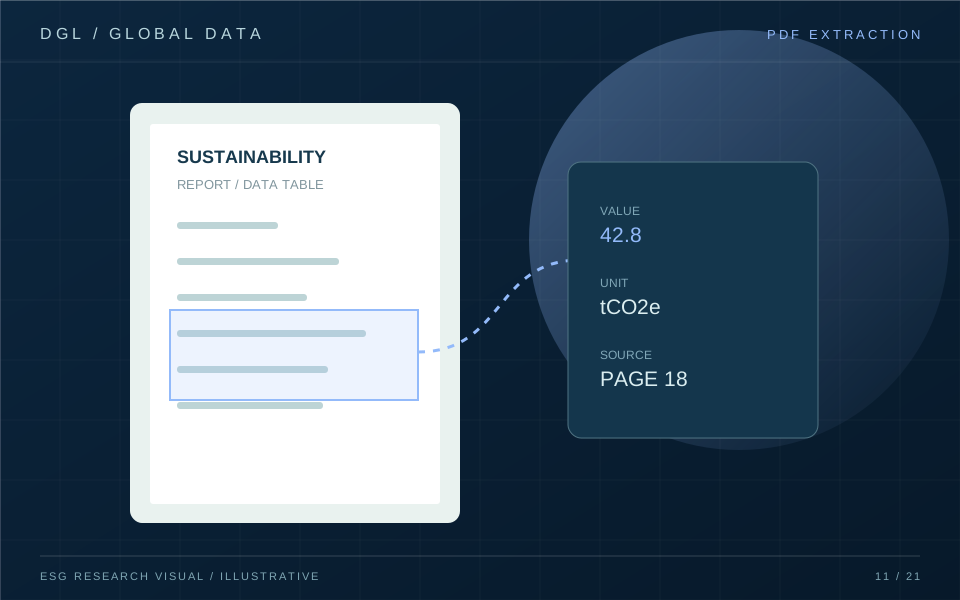
一份 PDF 报告可能把排放数据放在表格,把统计边界写在下一页脚注,把单位印在跨列标题里。机器如果只抓到数字,很可能得出错误结论。报告抽取的难点因此是恢复上下文。
先识别版面,再识别文本
原生 PDF 能读取文字层,但阅读顺序未必正确;扫描版需要 OCR,表格线、合并单元格和双栏排版会增加错误。处理流水线可以先进行页面布局分析,再区分正文、表格、图注与脚注。每个片段保存坐标和置信度,便于审核员打开原页。对数字特别密集的表格,图片裁剪与人工抽检通常比单纯文本输出更可靠。
表格需要行列语义
读取 12.4 这样的数值时,必须同时识别它属于哪家业务、哪个财年、哪种排放范围、什么单位。多级表头会使简单按行读取失效。可先建立表格网格,再将每个数据单元格与上方和左侧的表头关联。跨页续表也要合并,脚注编号要回连到对应行列。若表格写“单位:万吨”,后续换算必须把 12.4 转为 124000 吨。
多语言术语不能机械翻译
“gross emissions”“net emissions”“market-based emissions”含义不同;员工人数也可能按期末人数或平均全职等效口径披露。术语表和标准映射可帮助模型提出候选,但必须保留原语种和原文。对难以映射的自定义指标,应以未确定状态进入审核队列。翻译后的流畅中文不能代替指标定义。
用规则检查 AI 输出
抽取后检查单位、数值区间、分项求和、年度变化及同页文字说明。异常不必自动修正,因为企业经营变化可能真实造成大幅波动。把规则提示、原始片段和模型候选一起交给审核员,才便于判断。最终数据应带来源页、抽取方法、模型版本和审核状态,使将来复核时能重建全过程。
研究实践:把方法落实到记录
抽取评估不能只用‘找到了多少数字’。需要分别测量正确指标定位、数值精度、单位识别、脚注关联和无数据时拒答的表现。对扫描质量差的报告,应把 OCR 置信度与人工复核成本写进项目计划。少数关键高影响指标采用双人抽检,通常比盲目追求全自动更可靠。
进一步观察
一项排放指标可以用“候选—核验—入库”三级状态管理。模型初次识别后,先展示原页裁剪、表头和脚注;规则引擎确认量纲与总分项关系;审核员再决定是否入库。若规则发现与去年相比增加十倍,应提示原因调查,而非自动把数值除以十。真实并购或产能扩大也会带来极端变化。
报告中的图形还可能只展示柱状图,没有精确数值标签。此时图像识别可以估读趋势,却不应生成貌似精确的指标值。数据层应区分“明确披露的数值”和“从图形估算的数值”。多语言报告若同时提供英文和本地语版本,应记录以哪个版本为准,并把术语差异加入审核备注。
研究建议
面对长报告,审核资源可按风险分配:重大排放数值、事故数量和董事会关键变动进行人工复核;低影响叙述可抽样检查。对每类指标计算抽取准确率,单独分析扫描件与多语言报告的表现。这样自动化率不会成为唯一目标。
长期运行时,还应记录不同版式的错误分布。若某类报告总在跨页表格上失误,可以针对该版式优化解析器,或直接进入人工处理队列,避免反复产生同一种错误。每次修复后应重跑受影响的旧报告。
本文为基于公开资料的方法研究,不构成投资、法律或具体企业评级意见。引用标准与监管动态请以原发布机构的最新文本为准。